28 detectores de objetos, uma GPU de 4 GB: medindo acurácia e latência sem confiar nos números dos outros
Nos últimos posts, usei o YOLOv8 para reconhecer objetos e para contar carros na avenida em frente de casa. Em nenhum dos dois eu parei para perguntar o óbvio: por que o YOLOv8? Existem o YOLO11, o YOLO12, o RT-DETR, o RF-DETR, e ainda os clássicos como o Faster R-CNN. Cada um chega com um artigo dizendo que é o melhor.
O problema é que esses artigos não conversam entre si. Um mede numa A100 com TensorRT, outro numa V100 em PyTorch. Um inclui o NMS na latência, outro não. Um usa entrada de 640 px, outro de 800. Comparar as tabelas deles é como comparar o consumo de dois carros medido um na estrada e o outro no trânsito.
Então fiz o que dava para fazer: peguei 28 detectores de 7 famílias e medi todos no mesmo notebook, com o mesmo protocolo e o mesmo avaliador. O notebook tem uma RTX 3050 Laptop de 4 GB de VRAM. Não é hardware de laboratório, e foi de propósito: é o tipo de máquina em que muita gente realmente roda esses modelos.
A régua: o que significa "acurácia" em detecção
Antes de mostrar resultados, vale entender a métrica, porque "o modelo X tem 0,547 de mAP" esconde bastante coisa.
IoU: quando uma caixa está certa?
Um detector devolve caixas. Para decidir se uma caixa prevista acertou o objeto real , usamos a interseção sobre união:
O IoU vai de 0 (caixas disjuntas) a 1 (caixas idênticas). Uma predição conta como verdadeiro positivo se for da classe certa e tiver IoU acima de um limiar com algum objeto real ainda não "reivindicado". Caso contrário, é um falso positivo.
Precisão, revocação e AP
Ordenando as predições da mais confiante para a menos confiante e percorrendo a lista, a cada passo calculamos:
A precisão diz quanto do que o modelo apontou estava certo. A revocação diz quanto do que existia o modelo encontrou. Baixar o limiar de confiança aumenta e geralmente derruba . A curva resume esse compromisso, e a precisão média (AP) é a área sob ela:
No COCO, a integral é aproximada por 101 pontos de revocação, usando a precisão interpolada .
O mAP do COCO
O número que todo mundo reporta, o mAP@[.5:.95], faz duas médias em cima disso: sobre as 80 classes do COCO e sobre 10 limiares de IoU, de 0,50 a 0,95 em passos de 0,05:
A média sobre é o que torna a métrica exigente: com , a caixa precisa estar quase perfeita. Um modelo que "acha" os objetos mas desenha caixas frouxas vai bem no mAP50 e mal no mAP geral. A partir daqui, quando eu escrever mAP, é este.
O protocolo: medir latência é mais difícil do que parece
Se a acurácia tem um avaliador padrão (o pycocotools, que usei para todos os modelos), a latência não tem. Cada escolha muda o número, então aqui estão as minhas:
- Tempo total por imagem. Leitura do arquivo, pré-processamento, inferência e pós-processamento, incluindo o NMS. É o tempo que o seu pipeline realmente gasta, não só o da rede neural.
- Batch 1. O cenário de vídeo em tempo real: uma imagem por vez.
- Sincronização. A GPU é assíncrona: a chamada do PyTorch retorna antes de o cálculo terminar. Sem
torch.cuda.synchronize()antes de cada leitura de tempo, você mede o tempo de enfileirar o trabalho, e o número sai bonito e errado. - Aquecimento. As primeiras iterações pagam compilação de kernels e alocação de memória. Descartei 50 (Ultralytics e RF-DETR) ou 30 (torchvision e DETR).
- Mediana, não média. Com 5.000 medições, alguns tempos saem altos por motivos alheios ao modelo: o disco demorou, o sistema operacional interrompeu. A média é arrastada por esses valores; a mediana, não. Reporto também o percentil 95.
- Pesos oficiais. Todos pré-treinados no COCO train2017, sem ajuste por modelo, para eu não favorecer ninguém sem querer.
Cada modelo foi medido em FP32 e em FP16. Os portes l e x dos YOLO ficaram de fora pelo motivo mais prosaico possível: não cabem em 4 GB.
Os competidores
| Família | Variantes | Ideia central | |---|---|---| | YOLOv8, YOLO11, YOLO12 | n, s, m | CNN de um estágio, anchor-free, com NMS (o YOLO12 adiciona atenção) | | YOLOv9 | t, s, m | CNN com informação de gradiente programável | | YOLOv10 | n, s, m | CNN que dispensa o NMS | | RT-DETR | L | Transformer híbrido, end-to-end | | RF-DETR | Nano, Small, Medium, Base | Transformer com backbone DINOv2, end-to-end | | Faster R-CNN | v1, v2 | Clássico de dois estágios (2015) | | RetinaNet, FCOS, SSD, SSDlite | torchvision | Clássicos de um estágio | | DETR | ResNet-50 | O primeiro Transformer de detecção (2020) |
O resultado em um gráfico
A forma mais honesta de comparar modelos que trocam velocidade por acurácia é colocar os dois eixos no mesmo plano. Cada ponto abaixo é um modelo; o eixo horizontal é a latência em escala logarítmica e o vertical é o mAP.
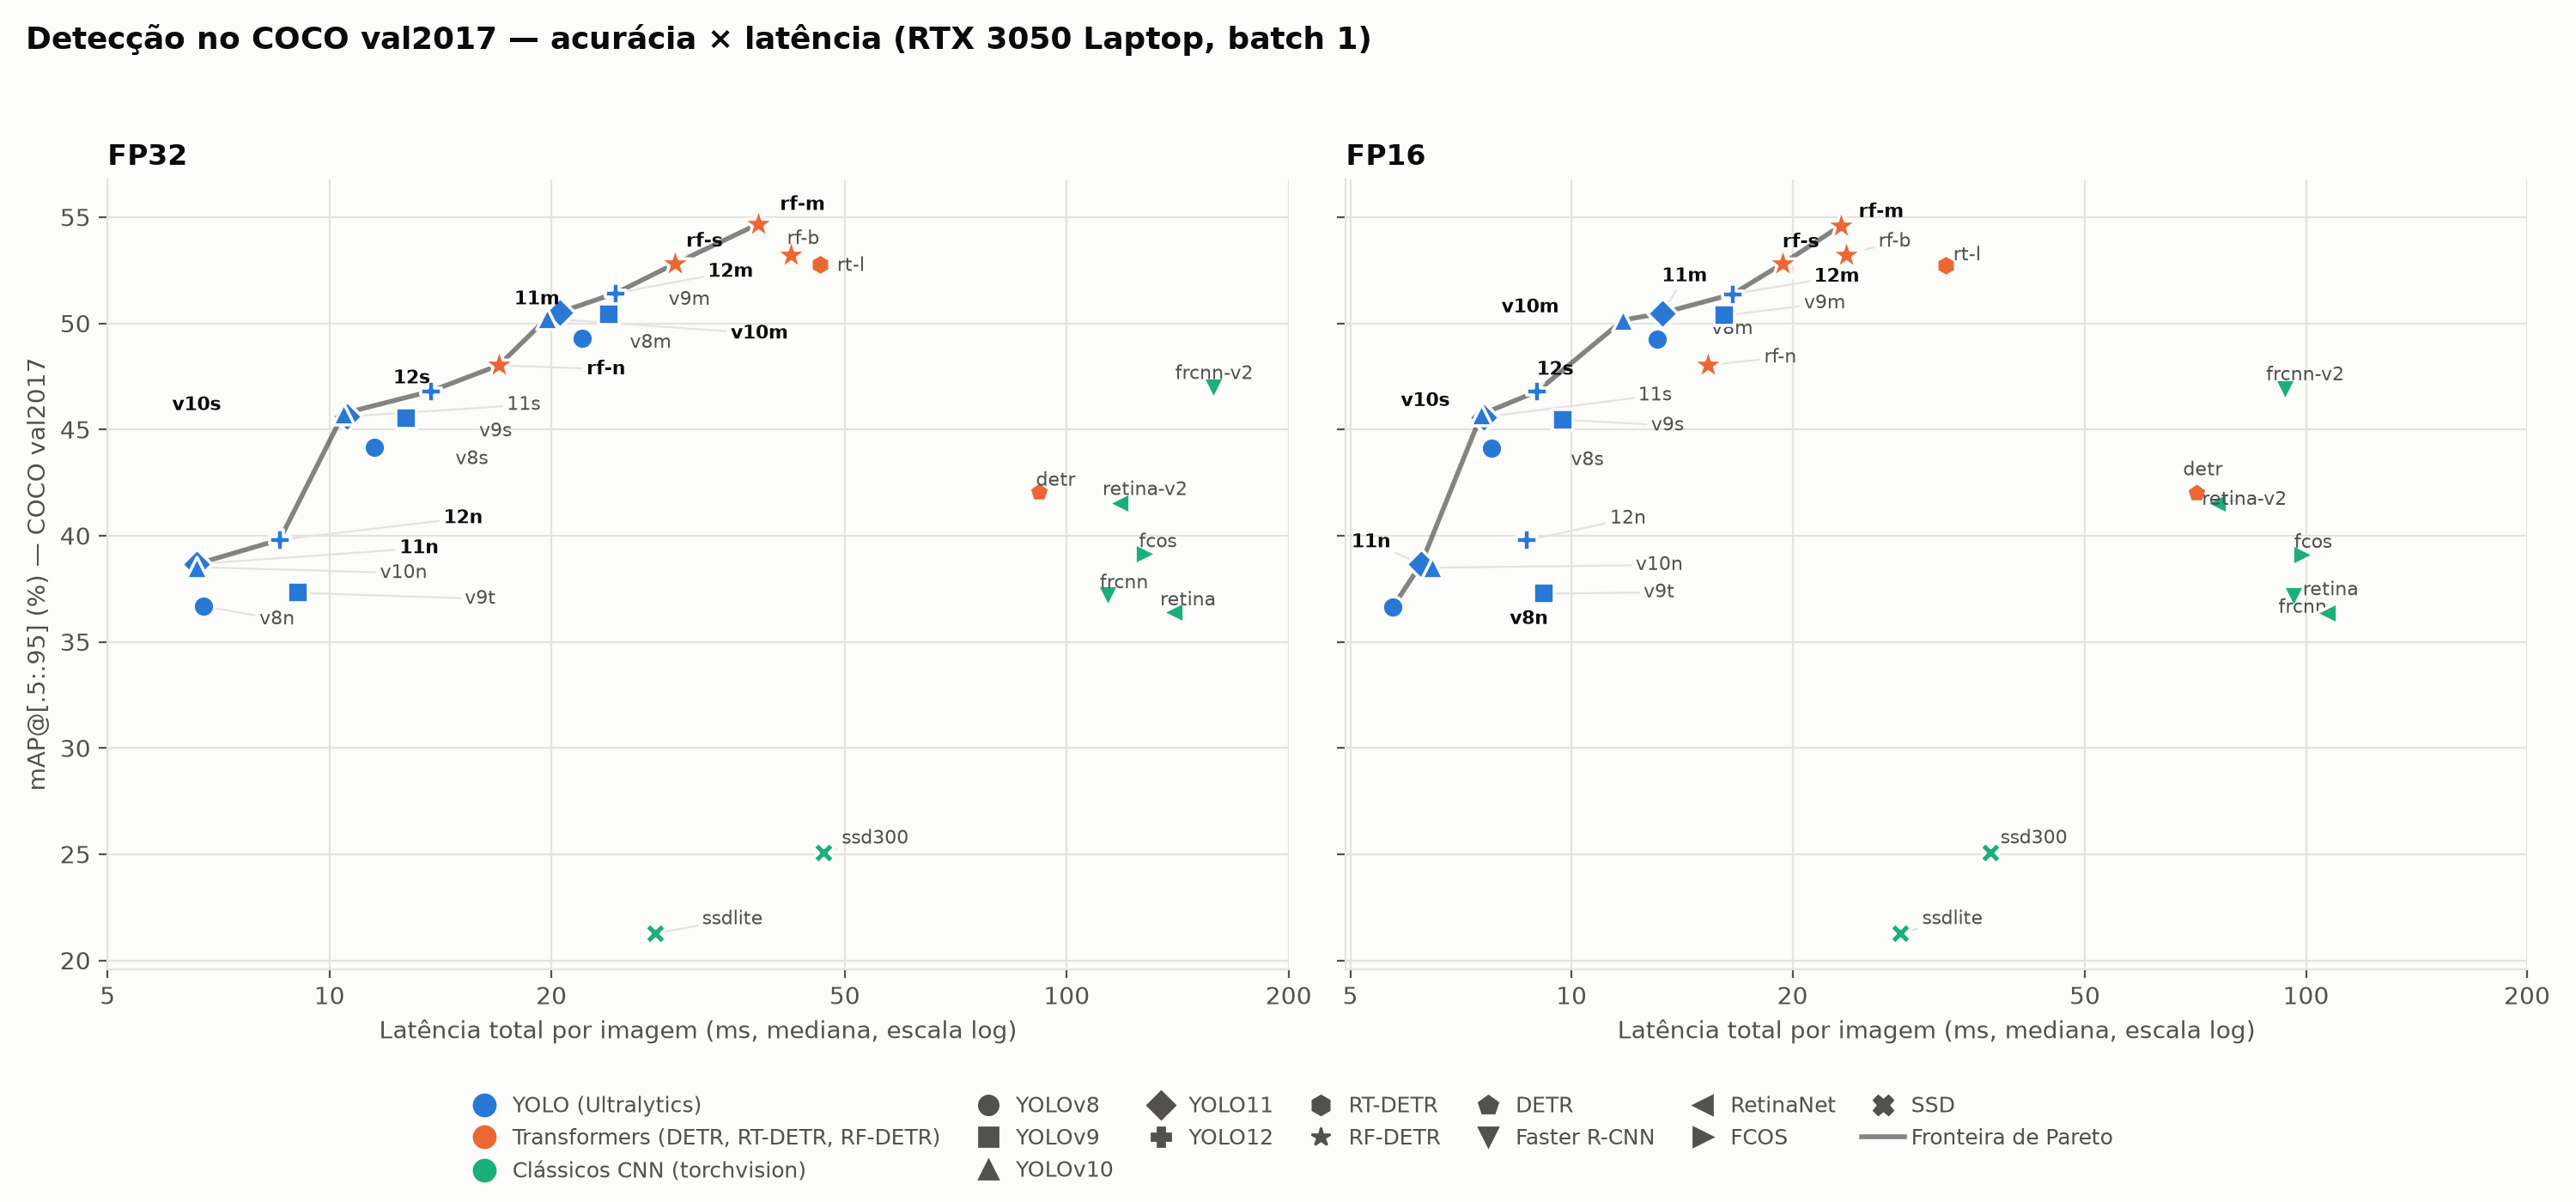
A linha cinza é a fronteira de Pareto, e ela merece uma definição precisa.
Dominância e fronteira de Pareto
Para cada modelo , temos um par : latência e acurácia. Queremos pequeno e grande. Dizemos que o modelo domina o modelo quando
ou seja, é pelo menos tão rápido e pelo menos tão preciso, e estritamente melhor em pelo menos um dos dois. A fronteira é o conjunto dos modelos que ninguém domina:
O valor prático disso é enorme: um modelo fora da fronteira nunca é a escolha certa (com o mesmo hardware e a mesma métrica). Sempre existe outro que faz o mesmo trabalho mais rápido, ou um trabalho melhor no mesmo tempo. Para o seu orçamento de latência , a melhor escolha é simplesmente o ponto mais alto de à esquerda de .
Calcular a fronteira é um algoritmo de poucas linhas: ordene por latência e guarde cada modelo que bate o recorde de acurácia até ali.
def fronteira_pareto(modelos):
    """modelos: lista de (nome, latencia_ms, map)."""
    fronteira, melhor_map = [], float("-inf")
    for nome, t, a in sorted(modelos, key=lambda m: (m[1], -m[2])):
        if a > melhor_map:
            fronteira.append(nome)
            melhor_map = a
    return fronteira
Aplicado aos 28 modelos em FP32, a fronteira sai, em ordem de latência:
YOLO11n → YOLO12n → YOLOv10s → YOLO12s → RF-DETR-Nano → YOLOv10m → YOLO11m → YOLO12m → RF-DETR-Small → RF-DETR-Medium
Dez modelos, e todos são YOLO ou RF-DETR. Nenhum detector clássico, e nem o RT-DETR-L, entra na fronteira. Em FP16 o desenho é quase o mesmo: o YOLO12n e o RF-DETR-Nano saem, e o YOLOv8n entra no começo.
Os números por trás do gráfico
Uma seleção dos 28 modelos, com latência mediana em milissegundos:
| Modelo | Entrada (px) | Params (M) | mAP | ms FP32 | ms FP16 | |:--|--:|--:|--:|--:|--:| | RF-DETR-Medium | 576 | 33,7 | 0,547 | 38,2 | 23,3 | | RF-DETR-Small | 512 | 32,1 | 0,528 | 29,4 | 19,4 | | RT-DETR-L | 640 | 33,0 | 0,528 | 46,2 | 32,3 | | YOLO12m | 640 | 20,2 | 0,514 | 24,4 | 16,6 | | YOLO11m | 640 | 20,1 | 0,505 | 20,5 | 13,3 | | YOLOv10m | 640 | 16,6 | 0,502 | 19,7 | 11,8 | | Faster R-CNN v2 | 800 | 43,7 | 0,469 | 158,3 | 93,6 | | YOLO11s | 640 | 9,5 | 0,456 | 10,6 | 7,6 | | DETR-R50 | 800 | 41,5 | 0,421 | 91,7 | 71,0 | | YOLO11n | 640 | 2,6 | 0,387 | 6,6 | 6,2 | | YOLOv8n | 640 | 3,2 | 0,367 | 6,8 | 5,7 | | SSD300 | 300 | 35,6 | 0,251 | 46,8 | 37,2 |
Três comparações resumem a tabela:
- O mais preciso. O RF-DETR-Medium lidera com 0,547, mesmo usando entrada menor (576 px) que a dos YOLO (640 px).
- O clássico contra o moderno. O Faster R-CNN v2, melhor dos clássicos, faz 0,469 em 158,3 ms. O YOLO11m faz 0,505 em 20,5 ms: mais preciso e cerca de 7,7 vezes mais rápido.
- Dois Transformers, destinos opostos. RT-DETR-L e RF-DETR-Small empatam em 0,528 de mAP, mas o primeiro gasta 46,2 ms e o segundo, 29,4 ms. Um está na fronteira; o outro, não.
E uma nota sobre o post anterior: o YOLOv8n, que usei para contar carros, faz 0,367 em 6,8 ms. O YOLO11n faz 0,387 no mesmo tempo, com menos parâmetros. Se eu refizesse o projeto hoje, trocaria.
Quatro coisas que eu não esperava
1. FP16 é quase de graça, e a matemática explica por quê
Um número em FP32 tem 23 bits de mantissa; em FP16, só 10. O erro relativo de arredondamento, o épsilon de máquina, salta de
Quase quatro casas decimais de precisão a menos. Mesmo assim, nos modelos Ultralytics o mAP não mudou mais que 0,001. Faz sentido: as redes são treinadas com ruído (dropout, aumento de dados) e aprendem a ser robustas a pequenas perturbações nos pesos e ativações. Um erro relativo de some no meio disso.
O ganho, em compensação, é grande: os modelos médios ficaram 30 a 40 % mais rápidos e usaram quase metade da VRAM. O RF-DETR-Base caiu de 42,3 para 23,6 ms sem perder um ponto de mAP.
2. Nos modelos pequenos, FP16 quase não ajuda
O YOLO11n foi de 6,6 para 6,2 ms; o YOLO12n até ficou um pouquinho mais lento (8,6 → 8,7 ms, dentro do ruído). A explicação é uma espécie de lei de Amdahl. Se a latência total é
e o FP16 só acelera a inferência, o ganho máximo é limitado pela fração . Num modelo de 6 ms, ler o arquivo, redimensionar a imagem e lançar os kernels custa quase tanto quanto a rede em si. Num modelo de 40 ms, a rede domina, e aí o FP16 brilha.
3. O FCOS quebra em FP16
A exceção à regra do item 1: o FCOS caiu de 0,392 para 0,310 de mAP com precisão mista, enquanto todos os outros ficaram iguais. Rodei um diagnóstico, que reproduziu o valor e mostrou a perda concentrada no mAP50 (0,583 → 0,451) e nos objetos pequenos. Minha suspeita é instabilidade numérica na cabeça do modelo ou na decodificação das caixas, onde um de pode virar alguns pixels de erro em coordenadas grandes. Mas ainda não confirmei a causa.
A lição independe dela: depois de converter um modelo para FP16, meça o mAP de novo. Funcionar para 27 modelos não garante o 28º.
4. Tirar o NMS não basta para ser rápido
O NMS (non-maximum suppression) é o pós-processamento que remove caixas duplicadas sobre o mesmo objeto. Os modelos end-to-end (YOLOv10, RT-DETR, RF-DETR) foram desenhados para dispensá-lo, e a promessa é menor latência. Os dados dizem que depende: YOLOv10 e RF-DETR estão na fronteira, mas o RT-DETR-L, também sem NMS, é dominado. Eliminar uma etapa não compensa se o resto do modelo é caro.
Objetos pequenos: onde os modelos realmente se separam
O mAP geral achata diferenças que aparecem quando olhamos só os objetos pequenos (área menor que pixels no COCO):
| Modelo | AP pequenos | |:--|--:| | RF-DETR-Medium | 0,358 | | YOLO12m | 0,345 | | RT-DETR-L | 0,344 | | YOLO11m | 0,334 | | Faster R-CNN v2 | 0,310 | | SSD300 | 0,055 | | SSDlite320 | 0,011 |
O SSDlite praticamente não enxerga objetos pequenos, e a razão é geométrica: com entrada de 320 px, uma imagem de 640 px é reduzida pela metade em cada eixo, e um objeto de pixels vira um borrão de . Lembrando dos carros distantes e escuros do projeto de contagem, que já tinham confiança baixa no YOLOv8: em casos assim, olhe esta coluna antes do mAP.
Então, qual usar?
Lendo a fronteira como um guia, para uma GPU de consumidor:
| Orçamento por imagem | Escolha | mAP | |:--|:--|--:| | ~7 ms | YOLO11n ou YOLOv10n | ~0,39 | | ~10 ms | YOLOv10s ou YOLO11s | ~0,46 | | ~20 ms | YOLO11m ou YOLOv10m | ~0,50 | | 30–40 ms | RF-DETR-Small ou Medium | 0,53–0,55 |
Ligue o FP16 nos modelos médios e grandes (e confira o mAP). E se você está usando um detector clássico por hábito ou porque o tutorial usava, os dados sugerem fortemente trocar.
O que este benchmark não prova
Um benchmark que não lista suas limitações está vendendo algo. As minhas:
- Resoluções diferentes. YOLO e RT-DETR rodam em 640 px; os clássicos, em 800; o RF-DETR, entre 384 e 576; o SSD, em 300. Parte da vantagem do YOLO sobre os clássicos pode vir da resolução, e não da arquitetura. (O RF-DETR vencer com entrada menor reforça a conclusão a favor dele.)
- Uma medição por modelo. Sem repetições, não há barras de erro. Diferenças de ~0,3 ms estão no ruído, então a ordem de vizinhos como YOLO11n e YOLOv10n é incerta.
- Calor. A GPU chegou a ~75 °C nas execuções longas. Não registrei o clock, e throttling não pode ser descartado.
- Um hardware, um dataset. Em GPUs de data center, com TensorRT ou em CPU, a fronteira pode mudar. Em outro domínio (imagens médicas, satélite), também.
- Arquitetura + receita. Com pesos oficiais, cada modelo vem com seu próprio treino. A comparação mede o pacote, não a arquitetura isolada.
- FP16 não idêntico entre famílias. Nos Ultralytics e no RF-DETR é
halfpuro; no torchvision e no DETR,torch.autocast(precisão mista).
Uma checagem de sanidade: o YOLO11n obteve 0,387 de mAP aqui, contra 39,5 % divulgados pela Ultralytics. A proximidade indica que avaliação e conversão estão corretas.
E um aviso fora da matemática: os YOLO da Ultralytics usam a licença AGPL-3.0, e RF-DETR e RT-DETR têm licenças próprias. Para uso comercial, isso pesa na escolha tanto quanto o mAP.
Próximos passos
O benchmark deixou perguntas abertas que pretendo responder em posts futuros:
- Repetir cada medição de 3 a 5 vezes, registrando temperatura e clock, para ter barras de erro.
- Igualar as resoluções entre famílias e medir de 320 a 1024 px.
- Achar a causa da queda do FCOS em FP16.
- Exportar para ONNX e TensorRT e ver como a fronteira se move.
- Estender para segmentação de instância.
Conclusão
Medindo 28 detectores no mesmo notebook de 4 GB, com o COCO val2017 como régua:
- A fronteira de Pareto é de YOLO e RF-DETR. Clássicos e RT-DETR-L ficam fora dela.
- O RF-DETR-Medium é o mais preciso (0,547); YOLO11 e YOLOv10 têm o melhor custo-benefício entre 6 e 20 ms.
- FP16 preserva a acurácia e corta 30 a 40 % da latência dos modelos médios, com o FCOS como exceção.
- Dispensar o NMS não garante velocidade.
Mas o que mais fica é o método. Um número de latência sem hardware, resolução, sincronização e estatística definidos não é comparável a nada. Antes de escolher um modelo pelo número de um artigo, meça no seu hardware, com o seu pipeline completo. Código, configurações e os resultados brutos (um JSON por modelo e precisão) acompanham o projeto, para quem quiser reproduzir ou estender o estudo.
Gostou deste artigo? Veja onde me encontrar.